ผมกดข้อความทั้งหมดโดยจํานวนคํา 8%, ยังคงมีข้อเท็จจริงพื้นฐานทั้งหมด, เบอร์เทนช์, อัตราอัตราและเหตุผลทางเทคนิค และลบลิงค์ทั้งหมด:
โปรแกรม Lightbits Inferra เร่งการดําเนินงานแคช KV ทําลายผนังความจําของ AI inference และปรับปรุงการใช้งาน GPU ได้อย่างมากบริษัทที่ให้บริการในด้านการเก็บข้อมูลในแบบบล็อกที่มีประสิทธิภาพสูง สร้าง Inferra เพื่อทําให้ความจําความถี่สูงของ GPU (HBM) เป็น virtualคาเช KV เก็บกุญแจความสนใจและมูลค่าที่คํานวณได้ก่อนในระหว่างการสรุป LLM โดยหลีกเลี่ยงการคํานวณข้อมูลลําดับใหม่ที่ไม่จําเป็น และส่งเสริมการทํางานของ AI ที่สร้างขึ้น
การแคช KV มาตรฐานจํากัดข้อมูลที่แคชไว้กับ GPU HBM เมื่อ HBM เต็มแล้ว คู่ KV ที่มีอยู่จะถูกถอนออกเพื่อข้อมูลใหม่ ซึ่งต้องใช้เวลาในการคํานวณใหม่เมื่อใช้ใหม่คาเช KV ระดับใหม่ขยายการเก็บข้อมูลไปยัง DRAM ของเซอร์เวอร์ขณะที่ระดับที่สูงกว่าจะมีความช้าในการเข้าถึงที่ยาวนานกว่า แต่ความช้านี้มักจะสั้นกว่าการคํานวณใหม่เวกเตอร์ต๊อกเกนที่กว้าง
Inferra แก้ไขปัญหาความจําที่สําคัญที่เกิดจากการขยายร่องรอยแคช KV สัมพันธ์ยาวการสรุป AI ที่สามารถปรับขนาดได้มากขึ้นโดยไม่ต้องปรับปรุง GPU และ HBM Hardware ที่แพงเพื่อขยายความจุของแคช.

ผู้ร่วมก่อตั้งและประธานกรรมการของ Lightbits Labs อวิกดอร์ วิลเลนซ์ ระบุว่าตลาดการสรุป AI 2026 ที่มีราคา 117 พันล้านดอลลาร์บังคับให้ผู้จําหน่ายที่เน้นการฝึกอบรมที่ผ่านมามีการปรับปรุงใหม่เขาเน้นว่า ระบบการเก็บและฝึกซ้อมที่เก่าสมัยไม่สามารถปรับปรุงต่อการปรับปรุงขัดขวางของแคช KV, เนื่องจากมันถูกออกแบบมาเพื่อพาราไดรจ์ของภาระงานที่หมดอายุ. โดยมีวัตถุประสงค์ในการสร้างให้กับประสิทธิภาพการสรุป GPU, Inferra ได้รับการรับรองคุณค่าในโปรแกรมเบต้าของลูกค้า,การขยาย NVMe ของผู้จําหน่ายมากกว่านวัตกรรม TCP เพื่อแก้ปัญหาการสรุปความเจ็บปวดที่ทันสมัย.
โดยใช้อัลการิทึมการลดข้อมูลก่อนที่ KV-cache ได้ปรับปรุงให้ดี Inferra จะลากข้อมูล KV cache ที่กําลังจะมาก่อนการต้องการ GPU โดยมีข้อดีหลัก 3 ประการสูงสุด 16 เท่าการประกอบการสรุปที่พร้อมกันบนฮาร์ดแวร์ GPU ที่มีอยู่พร้อมกับการปฏิบัติตาม SLA อย่างเคร่งครัด (ไม่ต้องปรับปรุงฮาร์ดแวร์); การปรับปรุงความอ่อนเพลียสูงถึง 100 เท่า และการสนับสนุนสําหรับหน้าต่างเนื้อหา 10 ล้านต๊อกเคน, การตัด TTFT และ TPOT ผ่านการคาดการณ์สถานะความสนใจก่อนการค้นหาแทนการคํานวณใหม่;และการแยกตัวเช่าที่ปลอดภัยด้วยการจัดการแคช KV ที่รวมกันอย่างฉลาดสําหรับคลัสเตอร์การสรุปที่ร่วมกัน.
Inferra ได้กําหนดใหม่เศรษฐศาสตร์การสรุปโดยการทําให้ความจํา GPU เป็นจริงผ่านความจําและการเก็บข้อมูลหลายชั้น โดยเปลี่ยนการเก็บ KV ที่แตกแยกเป็นชั้นข้อมูลที่คงอยู่และฉลาดลงประจําการบนเซอร์เวอร์ หน่วยส่วนของ x86, มันติดตามกิจกรรมของบล็อกแคช KV และใช้เครื่องยนต์ Sub-Linear Sparse Attention Prefetch (SLSAP)มันจัดอันดับและจัดลําดับความสําคัญของบล็อก KV ที่ใช้ซ้ําบ่อย, รวมถึง tokens ล่าสุด, เนื้อหาที่คล้ายกันในทางความหมายและรูปแบบโครงสร้างในชัตหลายรอบและการทํางาน RAG.ระบบจะเอาบล็อคที่เป้าหมายจาก DRAM ของเซอร์เวอร์หรือ SSD ภายนอกและล็อดมันไปยัง GPU HBM ผ่าน RDMA.
ผู้อํานวยการผลิตภัณฑ์และเทคโนโลยีผู้ใหญ่ของ OVH ยานีฟ ฟิดา ยืนยันว่า Inferra ส่งผลประโยชน์ในการใช้งาน GPU อย่างมาก โดยทําให้มีหน่วยงาน AI และโครงสร้างภาระงาน RAG ที่สามารถปรับขนาดและมีประหยัด
ผลการพิจารณาระเบียงของสาธารณะยืนยันการปรับปรุงผลงานอย่างรุนแรง: Qwen 2.5-7B (สภาพ 410K) เร่งขึ้น 102 × (72.6s → 711ms); DeepSeek-R1-70B (สภาพ 141K) ปรับปรุง 152 × (70.8s → 465ms);Llama-4-Scout (10M context) ประสบความสําเร็จในการกระโดด 380 × (1.5 ชั่วโมง → 13s)
อินเฟอรร่า ไม่ต้องใช้ฮาร์ดแวร์และเข้ากันได้กับโครงสร้างสรุปแหล่งเปิดทั่วไป Inferra รองรับพลੱਗอิน Dynamo, vLLM และ LMCacheมันให้การปรับขนาด TTFT แบบใต้เส้นตรง สัมพันธ์กับความยาวของแง่มุม, ขณะที่ผู้แข่งขันอย่าง DDN, VAST Data และ WEKA ให้บริการแค่การปรับขนาดเชิงเส้นหรือการสตรีมเมนต์แบบปฏิกิริยา. Lightbits ได้แสดงให้เห็นถึงการสรุปข้อสรุปสถานการณ์ 10M-token ที่มั่นคงบน GPUs L40S ของสินค้า,ค่าเทียบที่ไม่มีคู่แข่ง.
ราเมช เชตุเวตติ ผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการผู้อํานวยการการกําจัดสถานที่คาดเดาที่มีความยาวนานและทําให้ธุรกิจสามารถใช้รุ่นขนาดใหญ่และภาระงานในการโต้ตอบที่ยาวนานขึ้น โดยมีค่าใช้จ่ายในพื้นฐานที่ต่ํากว่าผู้ใช้สามารถประเมินผลประโยชน์ของการปรับปรุงค่าใช้จ่ายจาก Inferra ผ่านแพลตฟอร์มการประเมินประสิทธิภาพของผู้จําหน่ายInferra ประสบความสําเร็จ 100 × ถึง 280 × KV การเร่งแคชบนหน่วยงานทํางาน SSD ที่เก็บข้อมูลคอมพิวเตอร์.
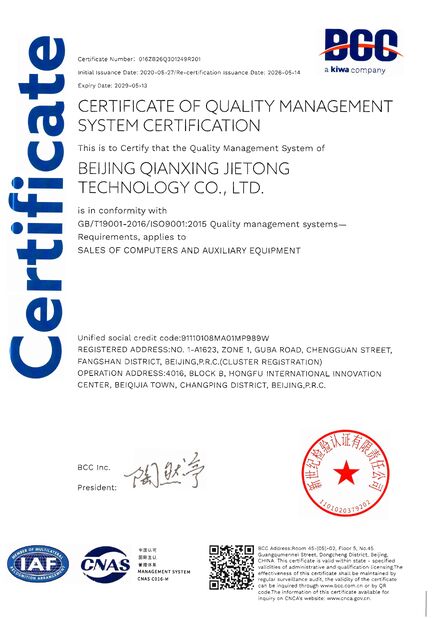
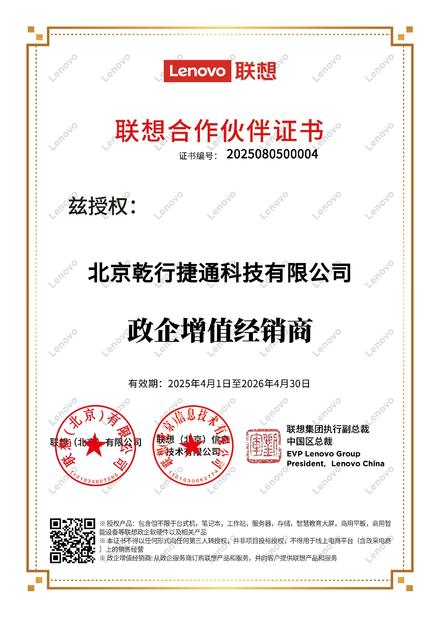
บริษัท เทคโนโลยีจีเทงจี (Beijing Qianxing Jietong Technology Co., Ltd.)
แซนดี้ แยง (Sandy Yang) ผู้อํานวยการยุทธศาสตร์โลก
วอทแอป / เวชแชท: +86 13426366826
อีเมล: yangyd@qianxingdata.com
เว็บไซต์: www.qianxingdata.com/www.storagesserver.com
เน้นธุรกิจ:
การจัดจําหน่ายสินค้า ICT/การบูรณาการระบบและบริการ/การแก้ไขพื้นฐาน
ด้วยประสบการณ์การจําหน่ายไอที 20 ปีขึ้นไป เราร่วมมือกับแบรนด์ชั้นนําระดับโลก เพื่อให้ผลิตภัณฑ์ที่น่าเชื่อถือและบริการมืออาชีพ
การใช้เทคโนโลยีเพื่อสร้างโลกที่ฉลาด ผู้ให้บริการสินค้า ICT ที่คุณไว้วางใจ


 ข้อความของคุณจะต้องอยู่ระหว่าง 20-3,000 ตัวอักษร!
 Thai